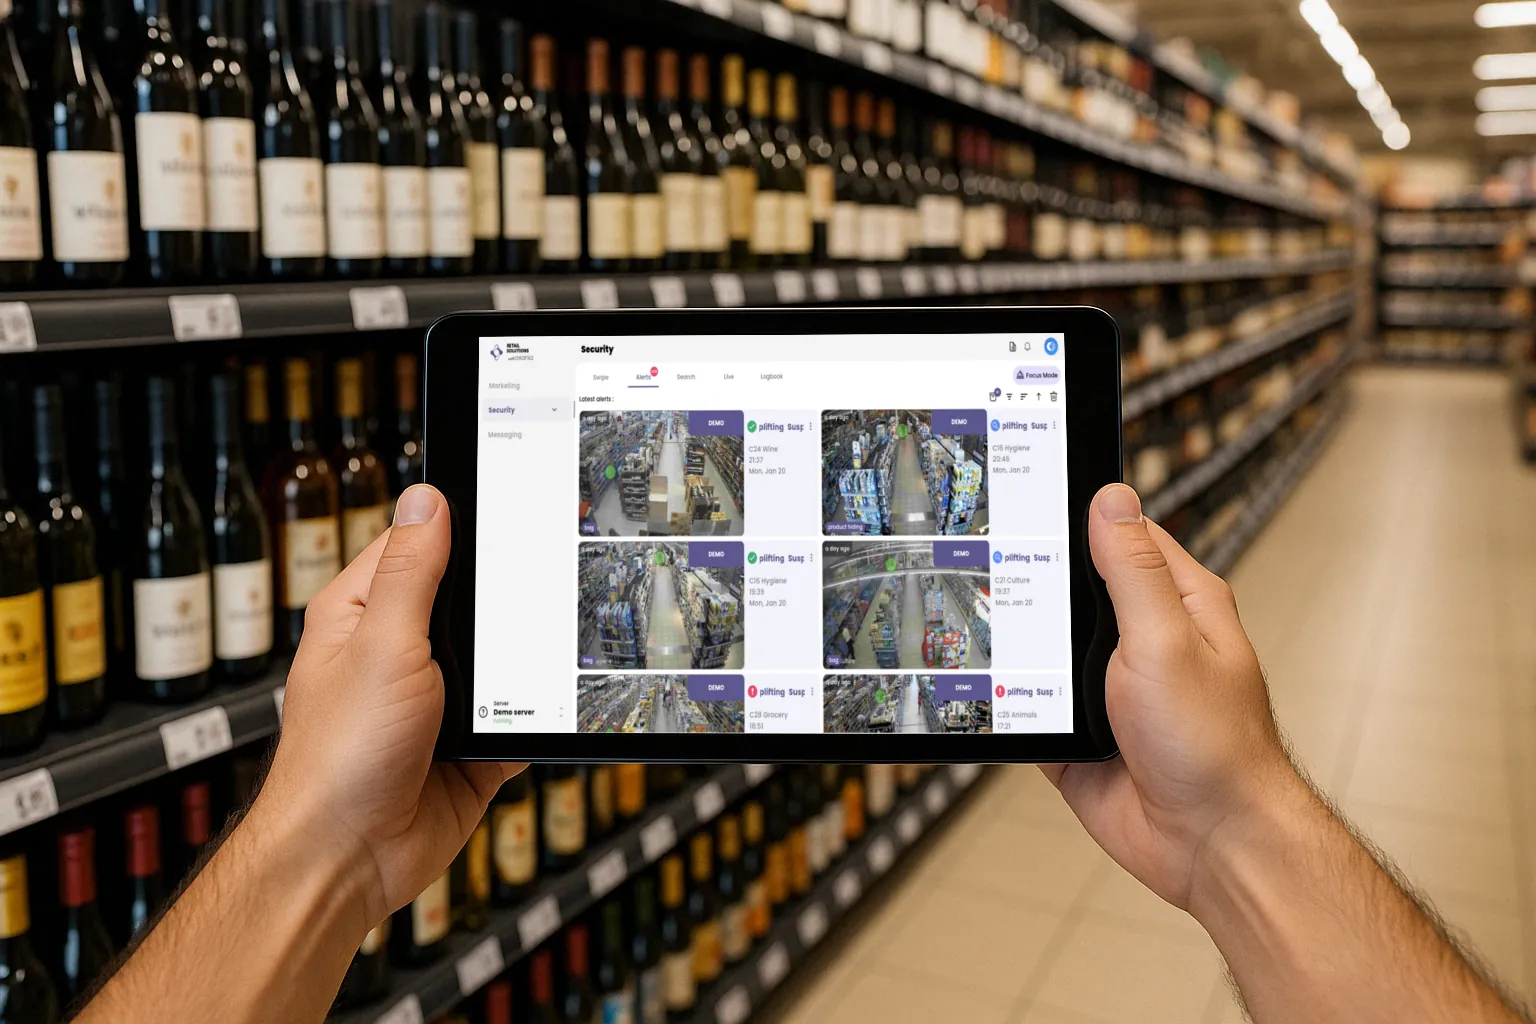
当零售商宣布将引入智能摄像头时,员工很少会提出技术方面的问题,而是会问:“它会盯着我看吗?”这个问题合情合理,一本商业宣传册也回答不了。想知道视觉 AI 在门店里究竟分析什么,最简单的办法就是跟随一帧画面的路径,从摄像头一直走到通知,并在途中记下模型所忽略的一切。
视频分析在零售业的部署其实仍然有限。在ECR Retail Loss 关于零售业视频分析的调查中,该调查于2024年面向70家零售商展开,其中大多数来自欧洲和北美,所统计的各类分析功能的平均使用率不超过10%,在销售区域内更是低至4%。由于行业内尚未形成共识,同一份报告给出了视频分析的一个工作定义:一种能够自动解读图像,并产出定义清晰且可付诸行动的结果的系统。接下来的一切,都围绕这两个词展开。
对视觉 AI 来说,“看见”意味着什么
摄像头传来的是一连串图像。而模型并不像货架区的员工那样“理解”一个场景:它是将手的位置、物品和动作与已学习的类别进行比对。当它观察到的内容与其中某一类别足够吻合时,就会生成一个事件:一种手势类型、一个区域、一个时间,以及一小段视频片段。仅此而已。
这时一切取决于图像的清晰度。在低分辨率视频流中,把剃须刀塞进外套口袋的那只手只剩下几个模糊的像素,因此基于高分辨率主码流的视频分析才有其价值。在 Oxania,这条主码流由安装在门店内的专用 GPU 处理:检测在本地完成,摄像头视频流不会离开现场,只有与警报相关的片段才会被保存,并存储在尽可能靠近客户所在国家的服务器上。
一套封闭的手势词汇表,而不是盯着人看
应用于损耗预防时,手势检测模型处理的是一份有限的类别清单。在盗窃方面,通常包括:
- 将商品藏进口袋、衣物下方或个人包中;
- 将商品放入背包、手提包或性质不明的袋子中;
- 在结账前拆开包装;
- 在店内直接食用,即饮用或食用未付款的商品;
- 购物车、婴儿推车或购物袋等有助于理解场景的背景要素。
有些系统还增加了跌倒警报,这对顾客和员工的安全比对商品更有用。这些类别都不会说明画面中的人是谁。风险手势检测针对的是某一时刻、某一区域内的一个动作。
AI 不做的事
排除项清单与检测项清单同样重要,而且往往正是它让团队感到安心。在此框架下设计的手势分析 AI:
- 不识别任何人:没有人脸识别,没有姓名,也没有人员档案;
- 不会跟踪个人从一个货架区到另一个货架区,也不会跨越多次到店访问;
- 不建立任何画像:无论年龄、出身,还是“有风险”的着装。统计数据按区域和时段查看,而不是按个人;
- 不判定意图:风险手势并不等于违法行为,只是一种值得人工关注的情形;
- 不衡量员工的工作:没有任何类别涉及工作效率、休息时间或流程合规性。
范围如此明确,这个工具的使用方式就很容易解释。无论对店员还是对顾客,都可以用一句话说清楚什么情况会触发警报,而这正是它能够被接受的原因。
警报不是裁决:决定权始终在人
模型有时会出错。比如一位顾客刚拿起一包咖啡,就把眼镜放进了口袋:在机器看来,这个场景很像是藏匿商品。因此,警报应被视为向团队提出的一个问题,而绝不是结论。
《欧盟人工智能法案》第14条关于人工监督的规定直截了当地指出了这个陷阱:自动化偏见,即自动或过度依赖机器输出结果的倾向。该条款要求负责监督的人员能够忽略、推翻或逆转系统的输出结果。该文本针对的是高风险系统,但没有什么能阻止我们对任何风险手势检测工具采用同样的规范。
在现场,收到警报的人会查看视频片段,然后做出选择:不采取任何行动、前往货架区域查看、主动向顾客提供帮助,或者在情况得到确认后,向有关部门报案。安保人员与人工智能协同工作,遵循一条简单的原则:技术负责检测,人负责决策。
对顾客和员工保持透明
2019年通过、并于2024年5月更新的经合组织人工智能原则,将透明度、可解释性和问责制列为可信赖人工智能五项原则之中的三项。在门店里,这体现为以下几个具体的做法:
- 安装前先说明。向团队展示系统检测什么、不检测什么,以及由谁接收警报。在有规定的情况下,让员工代表参与其中。
- 制定使用规则。这个工具用于减少损耗、保护人员,而不是考核员工:不如白纸黑字写清楚。
- 告知顾客。入口处的告示由运营方负责,与其现有的摄像头设施一样。一块清晰易读的标识牌和一份简短易查的说明,往往就足以消除顾虑。
- 培训如何解读警报。查看片段,保持礼貌,绝不仅凭一条通知就拦下某个人。
- 定期复盘。回顾被排除的警报,调整所覆盖的区域,并与团队分享从中学到的经验。
部署得当的话,视觉 AI 与其说是一只评判的眼睛,不如说更像一位词汇量非常有限的同事:它只提示手势,后续交给熟悉门店的人处理。最好在启动会上、甚至在安装设备之前,就向大家介绍这一框架。当团队清楚工具看什么、不看什么,他们才会真正用起它,而这时它才开始减少未知损耗。