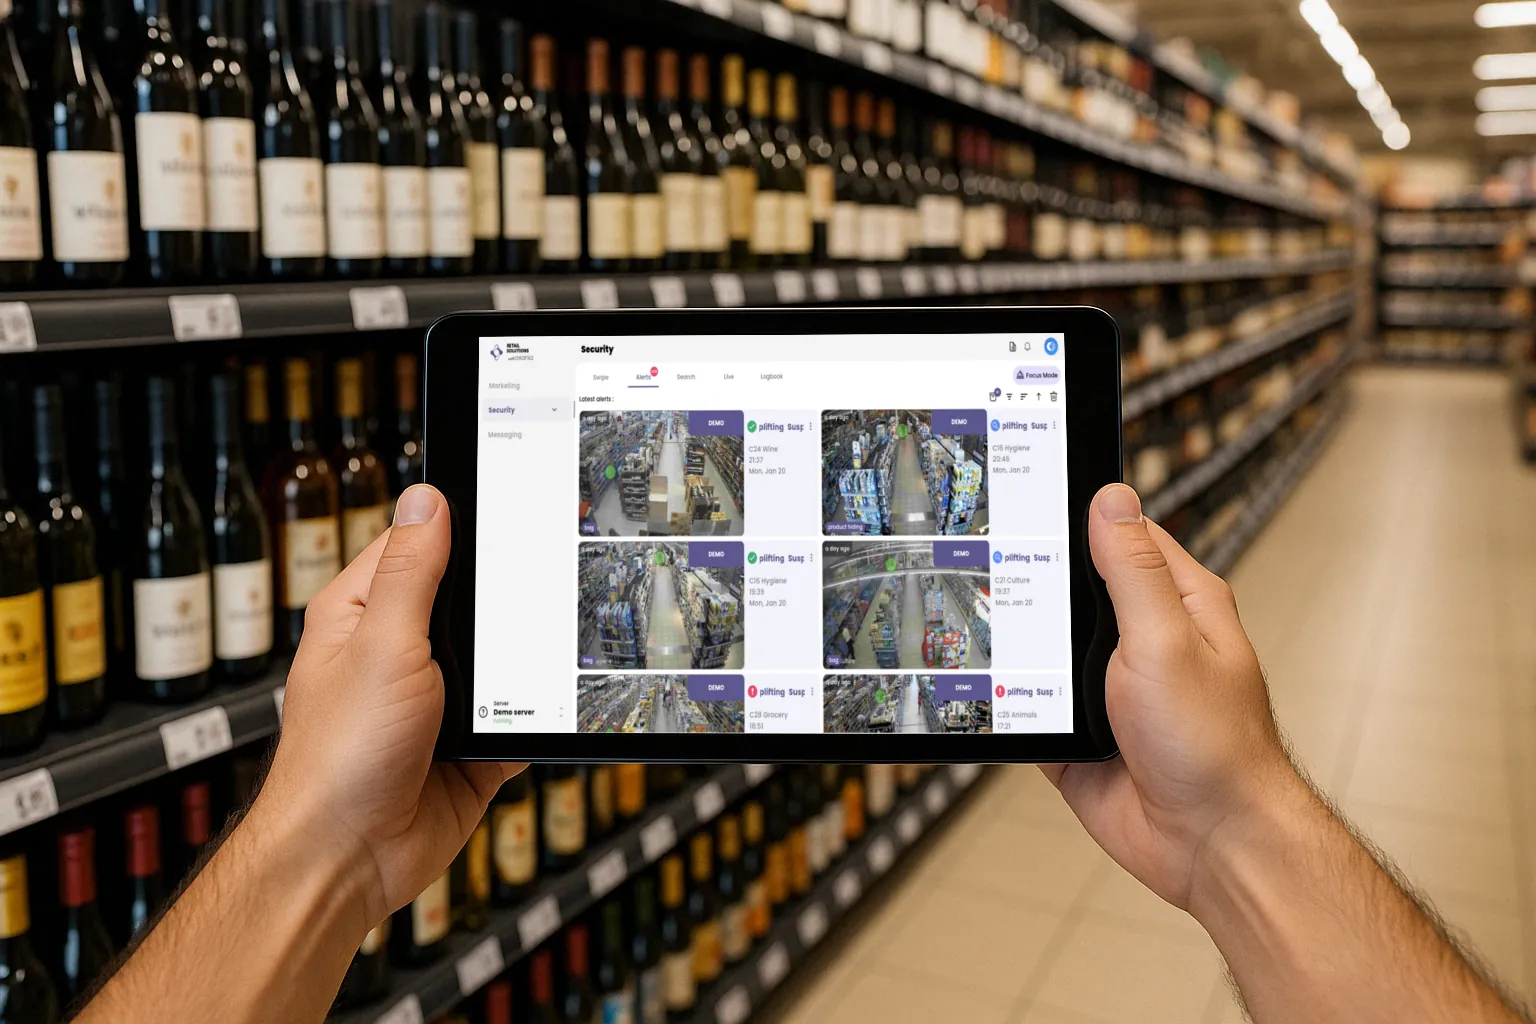
店舗がインテリジェントカメラの導入を告げるとき、現場のスタッフが技術的な質問をすることはほとんどありません。むしろ、こう尋ねます。「それは私のことも見るのですか?」。この疑問はもっともであり、営業用のパンフレットでは答えになりません。視覚AIが店舗で実際に何を分析しているのかを知るには、画像がカメラから通知に至るまでの道のりをたどり、その途中でモデルが無視するものをすべて書き留めてみるのが最も簡単です。
そもそも、ビデオ解析は小売業ではまだあまり導入が進んでいません。小売業におけるビデオ解析に関するECR Retail Lossの調査は、2024年に主に欧州と北米の小売企業70社を対象に実施されました。それによると、確認された解析の平均利用率は10%を超えず、売場では4%にまで下がっていました。業界内で共通認識がないため、同レポートはビデオ解析の作業上の定義を示しています。それは、画像を自動的に解釈して、明確に定義され、活用できる結果を生み出すシステムというものです。この先の話はすべて、この二つの言葉に集約されます。
視覚AIにとって「見る」とはどういうことか
カメラは連続した画像を送ります。一方、モデルは売場の従業員のように場面を「理解」するわけではありません。手の位置、物体、動きを、学習済みのカテゴリと照らし合わせているだけです。観察したものがいずれかのカテゴリに十分に一致すると、モデルはイベントを生成します。内容は、ジェスチャーの種類、ゾーン、時刻、短い映像クリップです。それ以上のものはありません。
そのため、すべては画像の精細さにかかっています。低解像度の映像では、ジャケットのポケットにカミソリを滑り込ませる手は、ぼやけた数ピクセルにしかなりません。だからこそ、高解像度のメインストリームでの映像解析が重要になります。Oxaniaでは、このメインストリームを店舗内に設置した専用GPUで処理します。検知はローカルで行われ、カメラの映像が店舗の外に出ることはなく、アラートに関連するクリップだけが、顧客の国にできる限り近いサーバーに保存されます。
人を見るのではなく、限定されたジェスチャーの語彙
ロスプリベンションに応用する場合、ジェスチャー検知モデルは限られた数のカテゴリで動作します。万引きに関しては、一般的に次のようなものがあります。
- 商品をポケット、衣類の下、または個人のバッグに隠す行為(隠匿)
- 商品をリュックサック、ハンドバッグ、または中身の定かでないバッグに入れる行為
- レジを通す前に包装を開ける行為
- 店内での飲食、つまり未精算の商品を飲んだり食べたりする行為
- カート、ベビーカー、買い物袋など、場面を読み取る助けとなる状況要素
システムによっては、転倒アラートが追加されることもあります。これは商品よりも、お客様やスタッフの安全に役立つものです。これらのカテゴリのいずれも、画像に映っているのが誰なのかを示すことはありません。リスクのあるジェスチャーの検知が対象とするのは、特定の瞬間に、特定のゾーンで行われた動作です。
AIがしないこと
検知対象のリストと同じくらい、除外対象のリストも重要であり、現場のスタッフを安心させるのはたいていこちらです。この枠組みで設計されたジェスチャー分析AIには、次の特徴があります。
- 誰も特定しません。顔認証も、氏名も、個人のデータベースもありません。
- 個人を、売場から売場へ、また来店のたびに追跡することはありません。
- いかなるプロファイリングも行いません。年齢も、出身も、「リスクのある」服装もありません。統計はゾーンと時間帯ごとに確認するもので、個人ごとではありません。
- 意図を判断しません。リスクのあるジェスチャーは犯罪ではなく、人の目で確認する価値のある状況にすぎません。
- 従業員の仕事ぶりを測定しません。生産性、休憩、手順の遵守に関するカテゴリは一切ありません。
対象がここまで絞り込まれていれば、ツールの使い方は簡単に説明できます。何がアラートのきっかけになるのかを、販売スタッフにもお客様にも一言で伝えることができ、まさにそれがツールを受け入れてもらいやすくしています。
アラートは判決ではありません。判断はあくまで人が行います
モデルは時に間違えます。たとえば、コーヒーのパックを手に取った直後に、眼鏡をポケットにしまうお客様を考えてみてください。機械にとって、その場面は隠匿のように見えます。そのためアラートは、結論ではなく、チームに投げかけられた問いとして扱う必要があります。
欧州AI規則の第14条(人間による監督)は、この落とし穴をはっきりと名指ししています。それが自動化バイアス、つまり機械の出力を自動的に、あるいは過度に信頼してしまう傾向です。同条は、監督を担う人が、システムの出力を無視し、置き換え、または覆すことができるようにすることを求めています。この条文の対象は高リスクのシステムですが、あらゆるリスクのあるジェスチャーの検知ツールに同じ規律を適用することを妨げるものは何もありません。
現場では、アラートを受け取った人が映像の抜粋を確認し、その上で判断します。何もしない、売場(ラック)を見に行く、お客様に声をかけて手助けを申し出る、あるいは状況が確認された場合は当局への対応に進む、といった選択肢があります。スタッフとAIは協力して働き、そこには単純なルールがあります。テクノロジーが検知し、人間が判断するということです。
お客様と従業員への透明性
2019年に採択され、2024年5月に改訂されたOECDのAI原則は、透明性、説明可能性、説明責任を、信頼できるAIの5つの原則に含めています。店舗では、これはいくつかの具体的な習慣として実践されます。
- 導入前に説明する。何が検知され、何が検知されないのか、誰がアラートを受け取るのかをスタッフに示します。定められている場合は、従業員代表も関与させます。
- 利用ルールを文書にする。このツールはロスを減らし、人を守るためのものであり、従業員を評価するためのものではありません。それを明文化しておきましょう。
- お客様に周知する。入口での表示は、既存のカメラ設備の場合と同様に、運営者の責任です。読みやすい掲示と、手に取れる短い説明書きがあれば、不安を和らげるのに十分なことが多くあります。
- アラートの読み方を教育する。クリップを確認し、礼儀正しく対応し、通知だけを根拠に誰かに声をかけることは決してしません。
- 定期的に振り返る。見送ったアラートを見直し、対象ゾーンを調整し、そこから学んだことをチームと共有します。
適切に導入された視覚AIは、人を裁く目というより、語彙がとても限られた同僚のようなものです。ジェスチャーを知らせ、その後の対応は店舗をよく知る人に任せます。この枠組みは、機器を設置する前、キックオフミーティングの段階から伝えておくのが望ましいでしょう。ツールが何を見ていて、何を見ていないのかを知っているチームは、本当にそれを活用します。そのときはじめて、ツールは不明ロス(démarque inconnue)の削減に貢献し始めます。