Ved udgangen af januar kommer årsopgørelserne af lageret ind til hovedkontoret, og i mange kæder cirkulerer det samme skema: en kolonne med butikker, en kolonne med svindprocenter, sorteret fra dårligst til bedst. På få sekunder ved alle, hvem der er »sidst«. Men den rangliste afspejler ofte lige så meget den måde, der tælles på, som selve tabene. For at sammenligne svindet fra butik til butik uden at ramme ved siden af, skal man først sørge for, at alle lokationer tæller på samme måde. Valget af nævnere kommer bagefter. Aflæsning pr. zone og tidsrum er til sidst den, der gør forskellene brugbare i butikken.
Hvorfor en rå rangliste over butikkerne vildleder
Den mest udbredte svindprocent sætter værdien af lagerdifferencer i forhold til omsætningen. Den er en god indikator for den generelle sundhedstilstand, men et dårligt redskab til rangordning, fordi den først og fremmest afhænger af, hvad hver enkelt butik medregner. I rapporten Beyond Shrinkage: Introducing Total Retail Loss påpeger professor Adrian Beck (University of Leicester), at fraværet af en fælles definition gør svinddata meget vanskelige at sammenligne: nogle virksomheder medregner kun uforklarede differencer, mens andre lægger brud, udløbne varer eller procesfejl oveni.
Det, der gælder mellem kæder, gælder også mellem butikkerne i samme kæde. De samme skævvridninger vender tilbage fra år til år:
- Tidspunktet for lageropgørelsen: en butik, der tælles lige efter udsalget, og en anden, der tælles før, taler ikke om den samme periode.
- Kendt svind, der er indberettet forkert: hver kasse med beskadigede varer, som ikke registreres, flyttes automatisk over i ukendt svind og får procenten til at stige.
- Fejl i de tidligere led: en ufuldstændig levering, en dårligt kontrolleret varemodtagelse eller en glemt overførsel mellem lokationer fremstår i butikken som tab.
- Størrelseseffekten: i en lille butik er tre eller fire dyre varer nok til at få procenten til at stige kraftigt fra det ene år til det andet.
- Produktmixet: en butik, der sælger flere meget udsatte varenumre, har logisk nok en højere procent.
Den sidste på ranglisten er derfor ikke nødvendigvis den dårligst drevne butik. Nogle gange er det den mindste. Eller den, der laver lageropgørelsen mest grundigt, eller den, der arver de mest problematiske leveringer fra lageret.
Harmonisér målingen før enhver sammenligning
Det nytter ikke at normalisere tal, der ikke måler det samme. Undersøgelsen Measuring Retail Shrink, udgivet af ECR Retail Loss, minder om det: for at sammenligne svindprocenter skal man kende deres beregningsmetode, anvende den konsekvent og være forsigtig med svind, der er værdisat forskelligt. Forfatterne, der bygger på en undersøgelse fra 2004 blandt detailhandlere i Europa, bemærker også, at tab i forsyningskæden, som sjældent måles, med stor sandsynlighed tillægges butikkerne og får svindet dér til at stige. De fleste respondenter målte dengang kun deres svind to gange om året; undersøgelsen anbefaler at tælle så ofte som muligt for at kunne reagere på nye tendenser.
I en kæde betyder det et skriftligt regelsæt, som anvendes overalt. Det fastlægger det præcise omfang af ukendt svind og værdiansættelsesmetoden (salgspris eller indkøbspris, men den samme på alle lokationer, og helst begge). Det samordner datoerne for lageropgørelserne og pålægger en ens håndtering af differencer ved varemodtagelsen. Hvis disse grundlag stadig mangler, gennemgår vores guide til at forstå, beregne og reducere ukendt svind beregningens grundprincipper. Arbejdet er tarveligt, men alt det øvrige afhænger af det.
Normalisér efter omsætning, kundetal og areal
Når målingen er harmoniseret, er der stadig valget af nævner. Hver af dem belyser et forskelligt aspekt, og ingen er tilstrækkelig alene.
- Pr. omsætning: det er den klassiske svindprocent, den der sammenlignes med markedets referencer. Ifølge NRF's National Retail Security Survey 2023 steg den gennemsnitlige svindprocent hos de adspurgte amerikanske detailhandlere til 1,6 % i regnskabsåret 2022 mod 1,4 % året før, hvilket svarer til niveauet i 2019 og 2020. Begrænsningen er velkendt: en butik med høj omsætning fortynder sine tab, og en stor kampagne (eller en stigning i salgspriserne, når svindet værdisættes til indkøbspris) flytter forholdet, uden at der ændrer sig noget på hylderne.
- Efter kundetal: tabet pr. tusind besøgende. På den måde neutraliserer man forskelle i gennemsnitlig kurvstørrelse og kan stille butikker op mod hinanden, hvor afdelingerne har sammenlignelige kundestrømme. Det kræver dog en pålidelig og ensartet optælling i hele kæden.
- Efter areal: tabet pr. kvadratmeter, eller endnu bedre pr. løbende meter for en given produktfamilie. Denne aflæsning bruges til at sammenligne eksponeringens tæthed og kvaliteten af indretningen, især mellem tætliggende formater.
Lad os tage et fiktivt og bevidst forenklet eksempel. Butik A i centrum har mange besøgende med små indkøbskurve. Butik B i udkanten har færre besøgende, men kurvene er store nok til, at den opnår en højere omsætning. Over året mister begge den samme varemæssige værdi. Set i forhold til omsætningen ser B bedre ud; set i forhold til besøgstallet er det A, der mister mindst pr. besøgende. Ingen af tallene er „det rigtige“. Det er deres divergens, der styrer analysen: mod eksponering for kundestrømmen hos A, mod varenumre med høj værdi hos B.
Sidste refleks: sammenlign hver butik med sine jævnbyrdige (samme format, samme type placering, tilsvarende størrelse) og med sin egen historik over flere lageropgørelser, snarere end med gennemsnittet for hele kæden.
Aflæs statistikkerne pr. zone og tidsrum
En årlig procent, selv vel normaliseret, fortæller hverken hvor eller hvornår tabene sker. To butikker med samme procent kan have modsatte situationer. I den ene er differencerne koncentreret om parfumeriet mellem kl. 17 og 19; i den anden fordeler de sig over hele salgsarealet om lørdagen. De to situationer håndteres ikke med den samme handlingsplan.
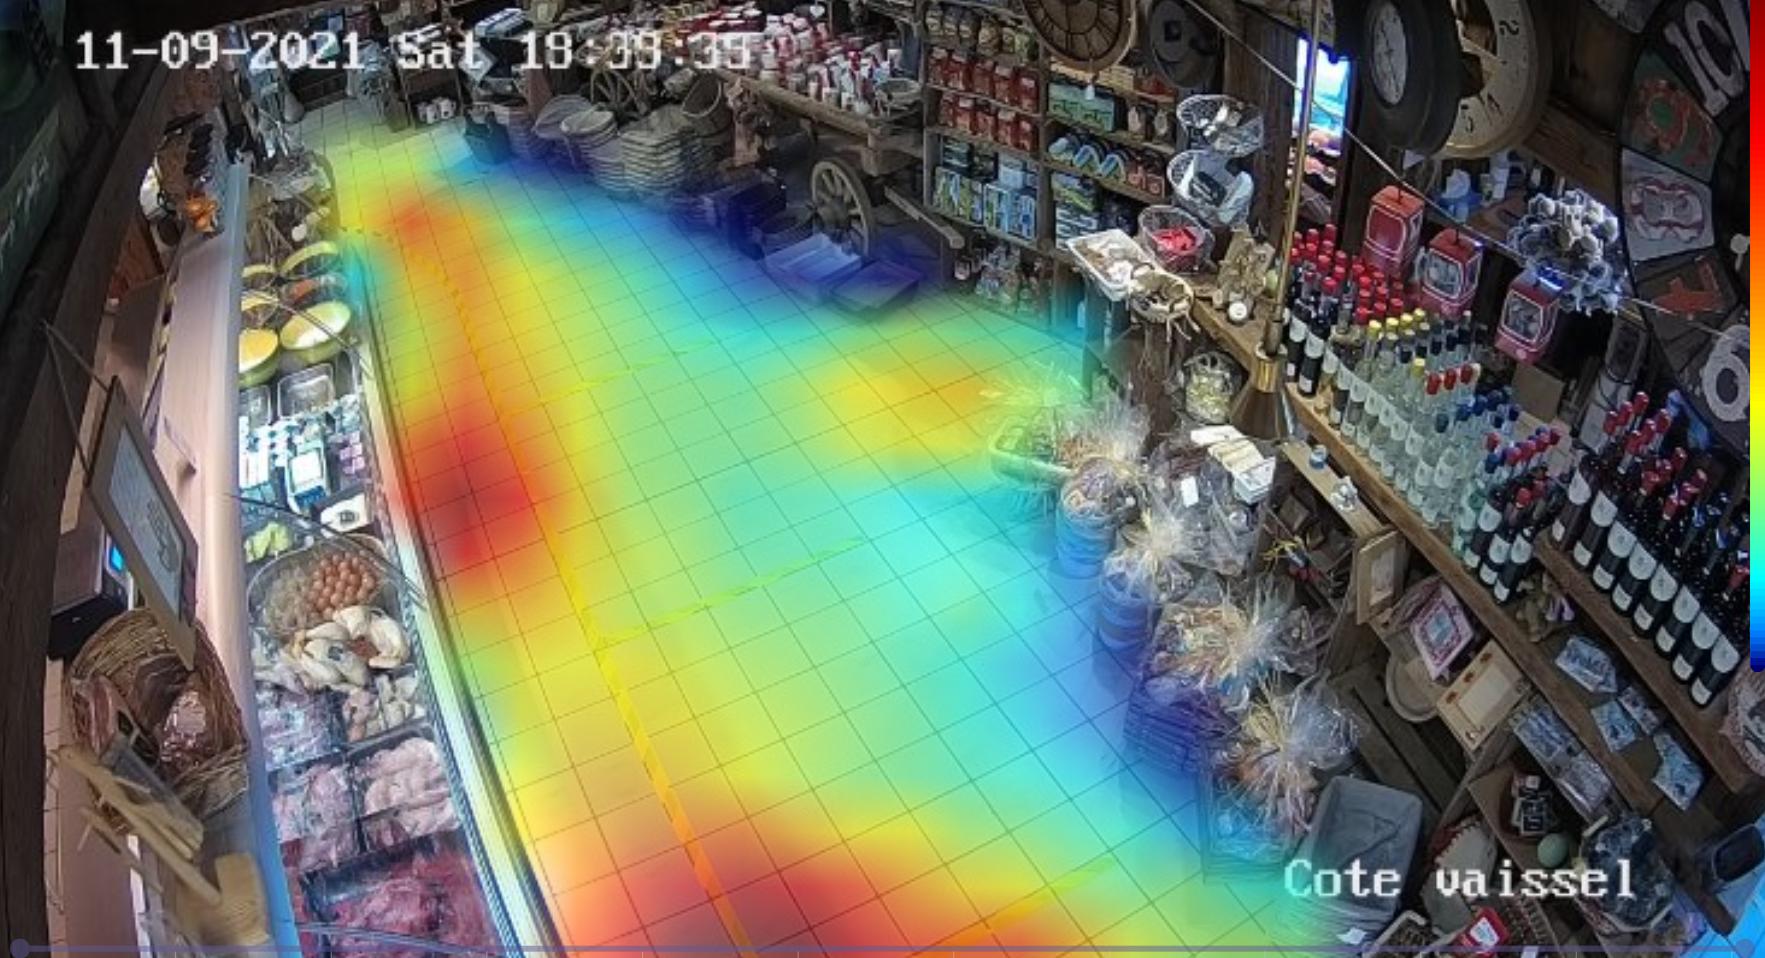
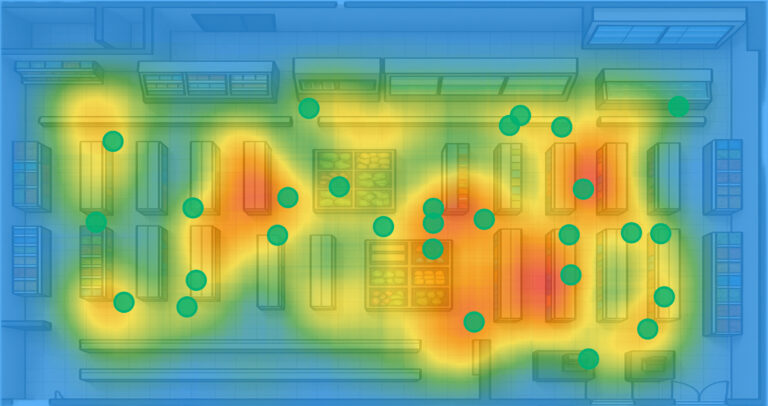
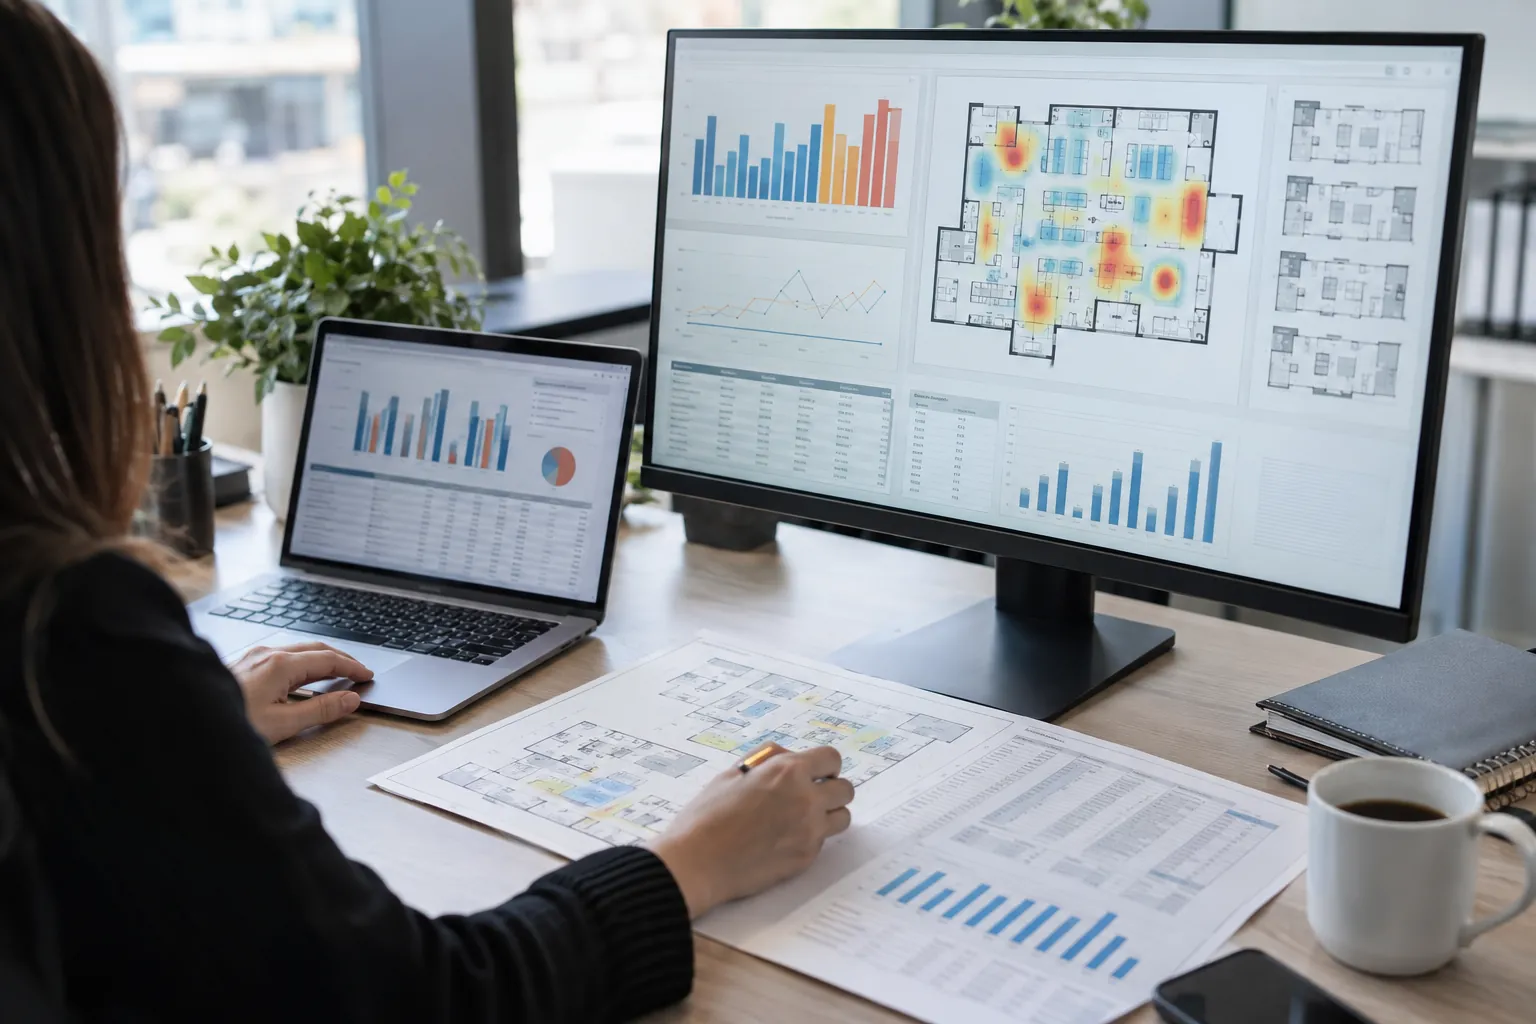
Her overtager data fra kameraerne efter lageropgørelsen. Dashboards til videoanalyse, som dem fra Oxania, samler besøgstælling, heatmaps og statistikker pr. zone og tidsrum. De erstatter ikke lageropgørelsen, som fortsat er målingen af det reelle tab, men de leveres løbende i stedet for en eller to gange om året. Kortlægningen af risikogester pr. zone giver så et grundlag for at sammenligne tilsvarende afdelinger fra butik til butik.
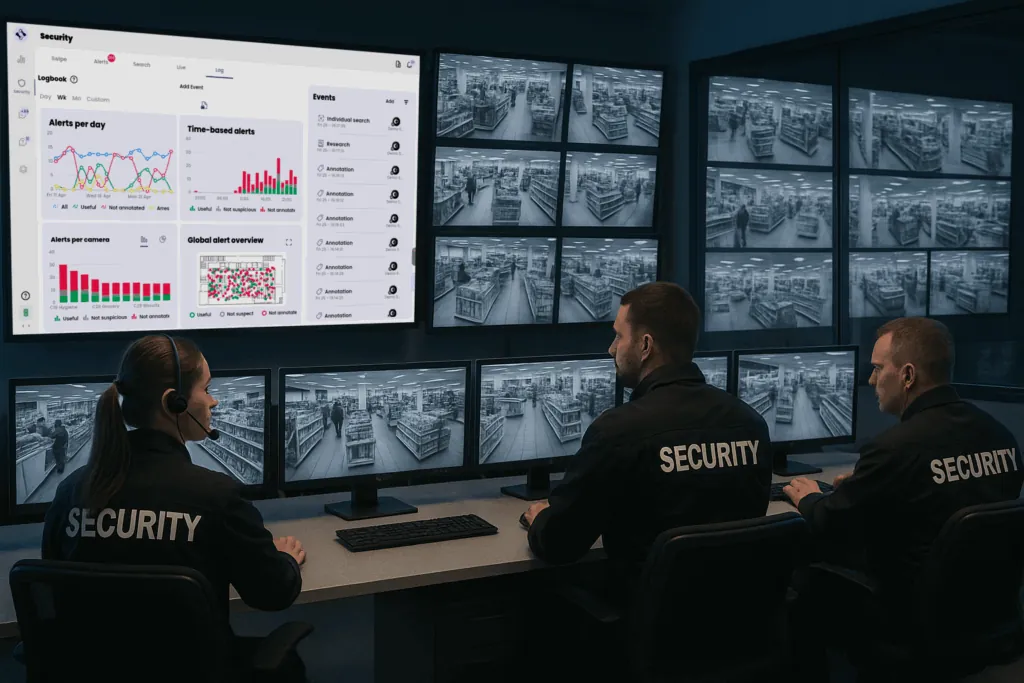
Vær dog opmærksom: antallet af alarmer afhænger også af, hvad kameraerne ser. En butik, hvor de udsatte afdelinger er godt dækket, vil indberette flere hændelser end en butik fuld af blinde vinkler, uden at være mere ramt af den grund. For at sammenligne bør man sætte alarmerne i forhold til zonens kundetal og kontrollere, at kameradækningen er tilsvarende fra lokation til lokation. Ellers er det den bedst udstyrede butik, der bliver straffet.
Erstat ranglisten med en sammenligning, der hjælper med at træffe beslutninger
En rangliste fra 1 til N, der udsendes til hele kæden, har en velkendt skadelig effekt, som controllere kender godt: man ender med at pleje indikatoren frem for virkeligheden. Brækkede varer indberettes med pludselig iver ugen før lageropgørelsen, og visse posteringer glider fra den ene periode til den anden. Og teamsene i de butikker, der strukturelt er mere udsatte og år efter år ligger i bunden af tabellen, mister modet.
En sammenligning, der er nyttig til styring af flere lokationer, ligner snarere dette:
- Grupper af sammenlignelige butikker, sammensat efter format, placering og størrelse.
- For hver butik tre indikatorer side om side (efter omsætning, pr. besøgende, efter areal) frem for kun én.
- En tendens over mindst tre perioder, så man kan skelne den enkeltstående hændelse fra en gradvis forskydning.
- Aflæsningsintervaller (inden for gruppens norm, bør undersøges, klart over) frem for en placering.
- Et zoom pr. zone og tidsrum for de butikker, der falder uden for deres interval, før man drager nogen konklusion.
- En samtale med butikkens ledelse for at forklare afvigelsen: ombygning, holdskifte, ny indretning, leveringsproblemer.
Denne tilgang bygger videre på de nøgleindikatorer, der kan forudse tab. Målet er ikke at udpege en dårlig elev, men at finde ud af, hvad der virker i de butikker, der klarer sig bedst, så det kan overføres til andre.
Når lagertallene kommer ind i slutningen af januar, tager det ti sekunder at sortere en kolonne. At harmonisere målingen, krydse omsætning, kundetal og areal og derefter gå ned på niveauet for zone og tidsrum kræver mere, men det følgende møde har ikke længere det samme formål: man holder op med at lede efter, hvem der er sidst, og spørger i stedet, hvor og hvornår man mister, og hvorfor. Det er ud fra dette spørgsmål, at det ukendte svind varigt falder i hele kæden.