I slutet av januari rapporteras bokslutsinventeringarna till huvudkontoret, och i många kedjor cirkulerar samma tabell: en kolumn med butiker, en kolumn med svinnprocent och en sortering från sämst till bäst. På några sekunder vet alla vem som är ”sist”. Problemet är att rankingen ofta speglar sättet att räkna lika mycket som själva förlusterna. För att jämföra svinnet mellan butiker utan att peka ut fel mål måste man först se till att alla butiker räknar på samma sätt. Valet av nämnare kommer därefter. Analysen per zon och tidsintervall är slutligen den som gör skillnaderna användbara i butik.
Varför en rå butiksranking vilseleder
Den vanligaste svinnprocenten sätter värdet av lagerdifferenserna i relation till omsättningen. Den är en bra indikator på den övergripande hälsan, men ett dåligt verktyg för rangordning, eftersom den först och främst beror på vad varje butik tar med i beräkningen. I sin rapport Beyond Shrinkage: Introducing Total Retail Loss påminner professor Adrian Beck (University of Leicester) om att bristen på en gemensam definition gör svinndata mycket svåra att jämföra: vissa företag räknar bara med oförklarade differenser, andra lägger till svinn genom skador, utgångna bäst före-datum eller processfel.
Det som gäller mellan kedjor gäller också mellan butikerna inom en och samma kedja. Samma skevheter återkommer år efter år:
- Inventeringstidpunkten: en butik som räknas direkt efter rean och en annan som räknas före den beskriver inte samma period.
- Känd svinn som rapporteras fel: varje låda med skadade varor som inte registreras hamnar automatiskt i det okända svinnet och driver upp dess andel.
- Fel uppströms: en ofullständig leverans, en dåligt kontrollerad mottagning eller en bortglömd överföring mellan butiker syns i butiken som förluster.
- Storlekseffekten: i en liten butik räcker det med tre eller fyra dyra artiklar för att procenten ska rusa från ett år till nästa.
- Produktmixen: en butik som säljer fler mycket utsatta artiklar har logiskt nog en högre procent.
Den som hamnar sist i rankingen är alltså inte nödvändigtvis den sämst skötta butiken. Ibland är det den minsta. Eller den som inventerar mest noggrant, eller den som får de mest problematiska leveranserna från lagret.
Harmonisera mätningen före varje jämförelse
Det är meningslöst att normalisera siffror som inte mäter samma sak. Studien Measuring Retail Shrink, som publicerats av ECR Retail Loss, påpekar just detta: för att jämföra svinnprocent måste man känna till hur de beräknats, tillämpa metoden konsekvent och vara försiktig när svinnet värderats olika. Dess författare, som bygger på en enkät från 2004 bland återförsäljare verksamma i Europa, konstaterar också att förluster i försörjningskedjan, som sällan mäts, med stor sannolikhet läggs på butikerna och blåser upp deras svinn. De flesta svarande mätte då sitt svinn bara två gånger per år; studien rekommenderar att räkna så ofta som möjligt för att kunna reagera på begynnande trender.
I en kedja innebär det en skriven spelregel som tillämpas överallt. Den fastställer den exakta avgränsningen av det okända svinnet och värderingssättet (försäljningspris eller inköpspris, men samma på alla butiker, och helst båda). Den synkroniserar inventeringsdatumen och föreskriver en identisk hantering av mottagningsdifferenser. Om dessa grunder fortfarande saknas går vår guide för att förstå, beräkna och minska det okända svinnet igenom grunderna i beräkningen. Arbetet är otacksamt, men allt annat hänger på det.
Normalisera per omsättning, besöksflöde och yta
När mätningen väl är harmoniserad återstår valet av nämnare. Var och en belyser en olika aspekt, och ingen räcker ensam.
- Per omsättning: det är den klassiska svinnprocenten, den som kan jämföras med marknadens referensvärden. Enligt NRF:s National Retail Security Survey 2023 steg den genomsnittliga svinnprocenten hos de tillfrågade amerikanska återförsäljarna till 1,6 % under räkenskapsåret 2022, jämfört med 1,4 % året före, och återgick därmed till nivån för 2019 och 2020. Begränsningen är välkänd: en butik med hög omsättning späder ut sina förluster, och en stor kampanj (eller en höjning av försäljningspriserna, när svinnet värderas till inköpspris) förskjuter kvoten utan att något förändrats i hyllorna.
- Per besöksflöde: förlusten per tusen besökare. På så sätt neutraliserar man skillnader i genomsnittligt kundkorgsvärde och kan ställa butiker mot varandra vars avdelningar har jämförbara flöden. Det förutsätter dock en tillförlitlig och enhetlig räkning av besökare i hela kedjan.
- Per yta: förlusten per kvadratmeter, eller ännu bättre per löpmeter för en given produktfamilj. Den här analysen används för att jämföra exponeringens täthet och kvaliteten på placeringen, framför allt mellan likartade format.
Låt oss ta ett fiktivt, medvetet förenklat exempel. Butik A, i centrum, har många besökare med små varukorgar. Butik B, i ytterområdet, har färre besökare, men deras varukorgar är tillräckligt stora för att ge en högre omsättning. Under året förlorar båda samma varuvärde. Sätts det i relation till omsättningen ser B bättre ut; sätts det i relation till besöksantalet är det A som förlorar minst per besökare. Ingen av siffrorna är ”den rätta”. Det är skillnaden mellan dem som styr analysen: mot exponeringen för kundflödet för A, mot artiklar med högt värde för B.
Sista reflexen: jämför varje butik med sina likar (samma format, samma typ av läge, liknande storlek) och med dess egen historik över flera inventeringar, snarare än med genomsnittet för hela kedjan.
Läs statistiken per zon och tidsintervall
En årlig procentsats, även väl normaliserad, säger varken var eller när förlusterna sker. Två butiker med samma procentsats kan ha helt motsatta situationer. Hos den ena är differenserna koncentrerade till parfymavdelningen mellan kl. 17 och 19, hos den andra är de spridda över hela butiksytan på lördagar. Dessa två situationer hanteras inte med samma handlingsplan.
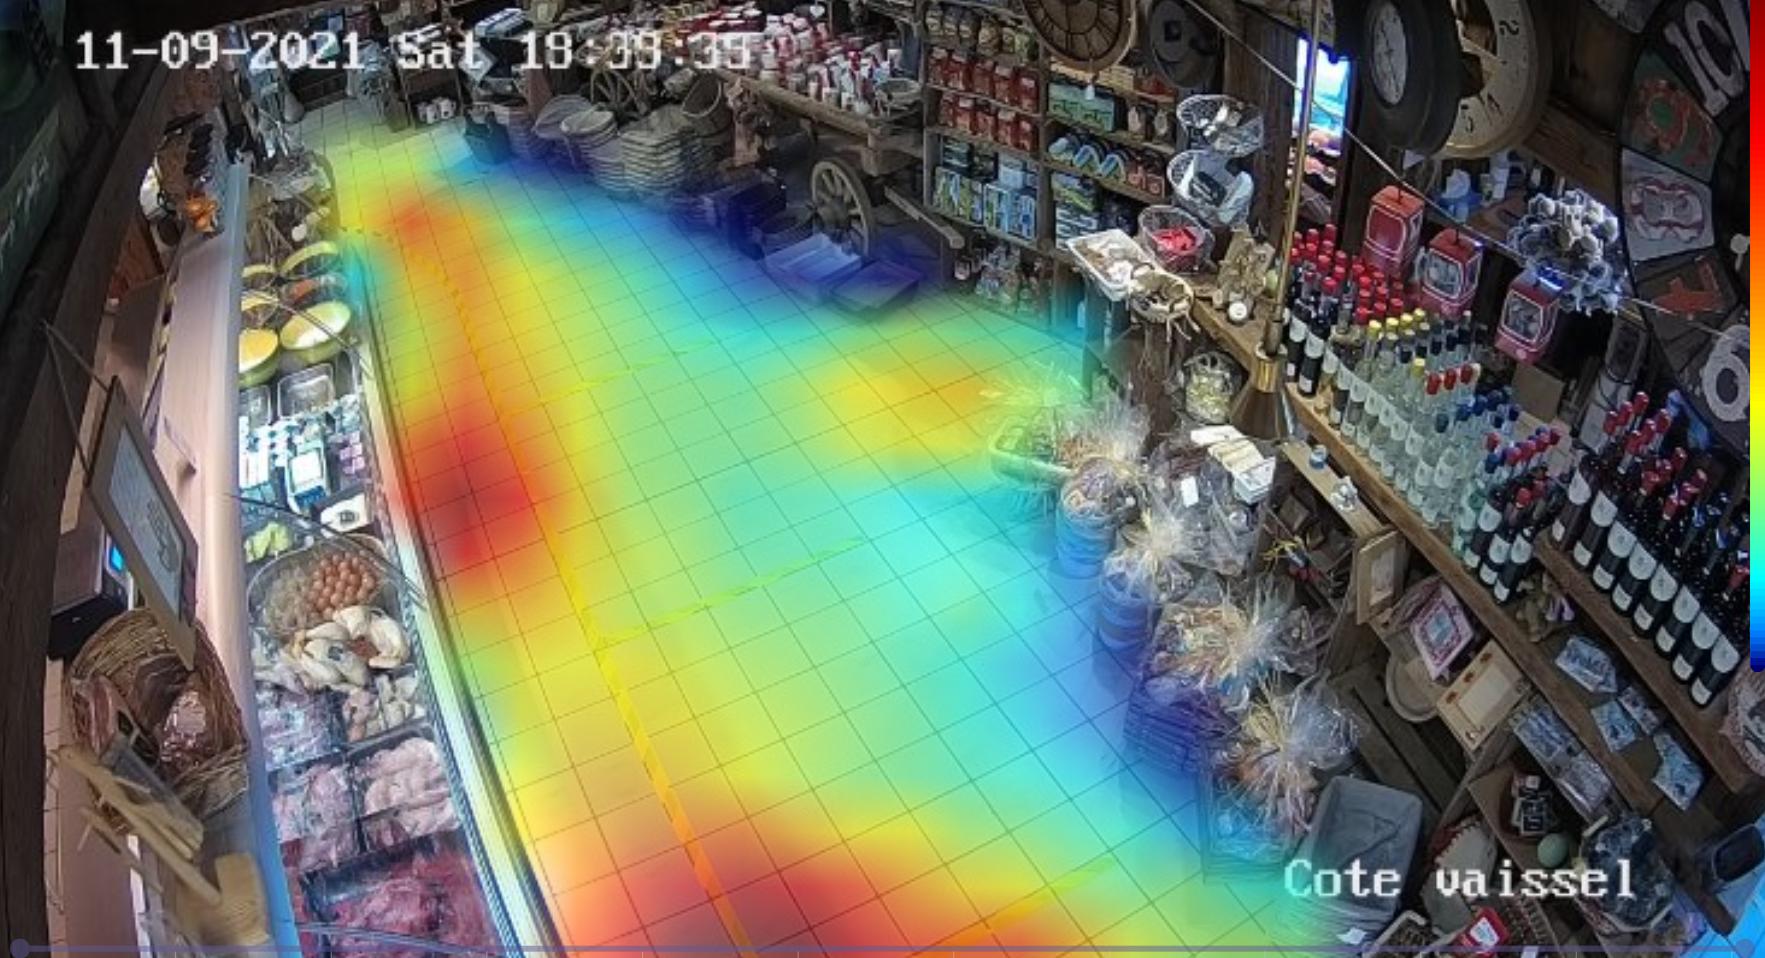
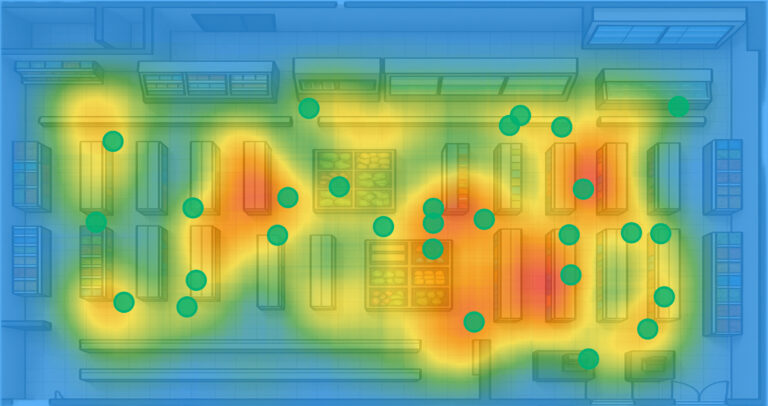
Här tar data från kamerorna över efter inventeringen. Dashboards för videoanalys, som Oxanias, samlar besöksräkning, heatmaps och statistik per zon och tidsintervall. De ersätter inte inventeringen, som fortsatt är måttet på den faktiska förlusten, men de kommer löpande i stället för en eller två gånger per år. Kartläggningen av gester som innebär risk per zon ger då en grund för att jämföra likvärdiga avdelningar mellan olika butiker.
Observera dock: antalet alerter beror också på vad kamerorna ser. En butik vars utsatta avdelningar är väl täckta registrerar fler händelser än en butik full av döda vinklar, utan att för den skull vara hårdare drabbad. För att jämföra bör ni sätta alerterna i relation till zonens besöksflöde och kontrollera att kameratäckningen är likvärdig från en butik till nästa. Annars är det den bäst utrustade butiken som blir missgynnad.
Ersätt rankingen med en jämförelse som underlättar beslut
En ranking från 1 till N som sprids till hela kedjan ger en välkänd perverterad effekt, väl bekant för controllers: man slutar med att vårda indikatorn i stället för verkligheten. Brytskador deklareras plötsligt med stor iver veckan före inventeringen, och vissa bokningar glider från en period till en annan. Och teamen i de strukturellt mer utsatta butikerna, som år efter år ligger i botten av tabellen, tappar motivationen.
En jämförelse som är användbar för styrning av flera butiker ser snarare ut så här:
- Grupper av jämförbara butiker, bildade utifrån format, läge och storlek.
- För varje butik tre indikatorer sida vid sida (per omsättning, per besökare, per yta) i stället för bara en.
- En trend över minst tre perioder, för att skilja den enstaka händelsen från en negativ utveckling.
- Tolkningsband (inom gruppens norm, bör undersökas, klart över) i stället för en placering.
- En inzoomning per zon och tidsintervall för de butiker som hamnar utanför sitt band, innan några slutsatser dras.
- Ett samtal med butikens ledning för att förklara avvikelsen: ombyggnad, byte av team, omplacering av varor, leveransproblem.
Det här arbetssättet bygger vidare på de nyckelindikatorer som hjälper att förutse förluster. Syftet är inte att peka ut en dålig elev, utan att upptäcka vad som fungerar i de butiker som klarar sig bäst, för att föra över det till andra.
När inventeringssiffrorna kommer i slutet av januari tar det tio sekunder att sortera en kolumn. Att harmonisera mätningen, korsa omsättning, besöksflöde och yta och sedan gå ner på zon- och tidsintervallnivå kräver mer, men mötet som följer har inte längre samma syfte: man slutar leta efter vem som är sist och frågar sig i stället var och när man förlorar, och varför. Det är utifrån den frågan som det okända svinnet minskar varaktigt i hela kedjan.