Eind januari komen de jaarafsluitende inventarissen binnen op het hoofdkantoor en in veel retailketens gaat dan hetzelfde overzicht rond: een kolom met winkels, een kolom met percentages voor onbekend voorraadverlies, gesorteerd van slechtste naar beste. In een paar seconden weet iedereen wie 'laatste' is. Alleen weerspiegelt deze ranglijst vaak net zozeer de manier van tellen als de verliezen zelf. Om het voorraadverlies van winkel tot winkel te vergelijken zonder de verkeerde doelwitten te kiezen, moet je eerst alle locaties op dezelfde manier laten tellen. De keuze van de noemers komt daarna. Het uitsplitsen per zone en per tijdslot is ten slotte wat de verschillen in de winkel bruikbaar maakt.
Waarom een ruwe ranglijst van winkels misleidend is
Het meest gebruikte shrinkagepercentage zet de waarde van de voorraadverschillen af tegen de omzet. Het is een goede indicator van de algemene gezondheid, maar een matig instrument om te rangschikken, omdat het in de eerste plaats afhangt van wat elke winkel in de berekening opneemt. In zijn rapport Beyond Shrinkage: Introducing Total Retail Loss, wijst professor Adrian Beck (Universiteit van Leicester) erop dat het ontbreken van een gemeenschappelijke definitie het zeer moeilijk maakt om shrinkagecijfers te vergelijken: sommige bedrijven houden alleen rekening met onverklaarde verschillen, andere voegen daar breuk, houdbaarheidsverlies of procesfouten aan toe.
Wat geldt tussen retailketens, geldt ook tussen de winkels van hetzelfde netwerk. Dezelfde vertekeningen keren van jaar tot jaar terug:
- Het inventarismoment: een winkel die vlak na de uitverkoop wordt geteld en een andere die ervoor wordt geteld, hebben het niet over dezelfde periode.
- Bekende shrinkage die verkeerd wordt geregistreerd: elke doos breuk die niet wordt ingevoerd, belandt automatisch in de onbekende shrinkage en verhoogt het percentage ervan.
- Fouten vooraf in de keten: een onvolledige levering, een slecht gecontroleerde ontvangst of een vergeten overdracht tussen vestigingen komen in de winkel naar voren als verliezen.
- Het effect van de omvang: in een kleine winkel zijn drie of vier dure artikelen genoeg om het percentage van het ene jaar op het andere sterk te laten stijgen.
- De productmix: een winkel die meer sterk blootgestelde referenties verkoopt, heeft logischerwijs een hoger percentage.
De laatste in de ranglijst is dus niet per se de winkel die het slechtst wordt beheerd. Soms is het de kleinste winkel. Of de winkel die het zorgvuldigst inventariseert, of nog de winkel die de meest problematische leveringen van het magazijn krijgt.
De meting harmoniseren vóór elke vergelijking
Cijfers normaliseren die niet hetzelfde meten, heeft geen zin. De studie Measuring Retail Shrink, gepubliceerd door ECR Retail Loss, benadrukt het: om shrinkagepercentages te vergelijken, moet je weten hoe ze zijn berekend, die methode consequent toepassen en voorzichtig blijven bij shrinkage die op een verschillende manier is gewaardeerd. De auteurs, die zich baseren op een enquête uit 2004 onder distributeurs in Europa, merken ook op dat verliezen in de toeleveringsketen, die weinig worden gemeten, een grote kans lopen aan de winkels te worden toegerekend en daar de shrinkage op te drijven. De meeste respondenten maten hun shrinkage toen slechts twee keer per jaar; de studie raadt aan zo vaak mogelijk te tellen, om te kunnen reageren op zich aftekenende trends.
In een netwerk vertaalt dit zich in spelregels die op papier staan en overal worden toegepast. Ze leggen de exacte reikwijdte van onbekend voorraadverlies (shrinkage) vast en de waarderingsmethode (verkoopprijs of inkoopprijs, maar op alle locaties dezelfde, en idealiter beide). Ze stemmen de inventarisatiedata op elkaar af en leggen een identieke behandeling van ontvangstverschillen op. Als deze basis nog ontbreekt, behandelt onze gids om onbekend voorraadverlies te begrijpen, te berekenen en te verminderen de basisprincipes van de berekening. Het werk is niet dankbaar, maar al het andere hangt ervan af.
Normaliseren op basis van omzet, bezoekersaantallen en oppervlakte
Zodra de meting is geharmoniseerd, blijft de keuze van de noemer over. Elke noemer belicht een ander aspect, en geen enkele volstaat op zichzelf.
- Per omzet: dit is het klassieke shrinkagepercentage, dat met de marktreferenties kan worden vergeleken. Volgens de National Retail Security Survey 2023 van de NRF, steeg het gemiddelde shrinkagepercentage van de ondervraagde Amerikaanse distributeurs in boekjaar 2022 naar 1,6 %, tegen 1,4 % het jaar daarvoor, en kwam daarmee terug op het niveau van 2019 en 2020. De beperking ervan is bekend: een winkel met een hoge omzet verdunt zijn verliezen, en een grote promotie-actie (of een verhoging van de verkoopprijzen, wanneer de shrinkage tegen inkoopprijs wordt gewaardeerd) laat de ratio verschuiven zonder dat er iets verandert in het schap.
- Per bezoekersaantal: het verlies per duizend bezoekers. Zo worden verschillen in gemiddelde besteding weggewerkt en kunnen winkels met elkaar worden vergeleken waarvan de schappen een vergelijkbare stroom bezoekers zien passeren. Dan is wel een betrouwbare en uniforme telling nodig in het hele netwerk.
- Per oppervlakte: het verlies per vierkante meter, of beter nog per strekkende meter van een bepaalde productfamilie. Deze meting dient om de blootstellingsdichtheid en de kwaliteit van de inrichting te vergelijken, vooral tussen vergelijkbare formats.
Laten we een fictief, bewust vereenvoudigd voorbeeld nemen. Winkel A, in het stadscentrum, ziet veel mensen met kleine mandjes langskomen. Winkel B, aan de rand van de stad, ontvangt minder bezoekers, maar zijn mandjes zijn groot genoeg om een hogere omzet te realiseren. Over het jaar verliezen beide dezelfde waarde aan goederen. Afgezet tegen de omzet lijkt B beter; afgezet tegen het bezoekersaantal verliest A het minst per bezoeker. Geen van beide cijfers is “het juiste”. Het is hun verschil dat de analyse richting geeft: naar de blootstelling aan de bezoekersstroom voor A, naar de artikelen met hoge waarde voor B.
Laatste reflex: vergelijk elke winkel met vergelijkbare winkels (zelfde formaat, zelfde type locatie, vergelijkbare grootte) en met de eigen historiek over meerdere inventarissen, in plaats van met het gemiddelde van het hele netwerk.
Bekijk de statistieken per zone en per tijdslot
Een jaarlijks percentage, ook als het goed genormaliseerd is, zegt niet waar of wanneer de verliezen plaatsvinden. Twee winkels met hetzelfde percentage kunnen een totaal tegengestelde situatie hebben. Bij de ene concentreren de afwijkingen zich op de parfumerie tussen 17.00 en 19.00 uur; bij de andere zijn ze op zaterdag verspreid over de hele verkoopvloer. Die twee situaties pak je niet aan met hetzelfde actieplan.
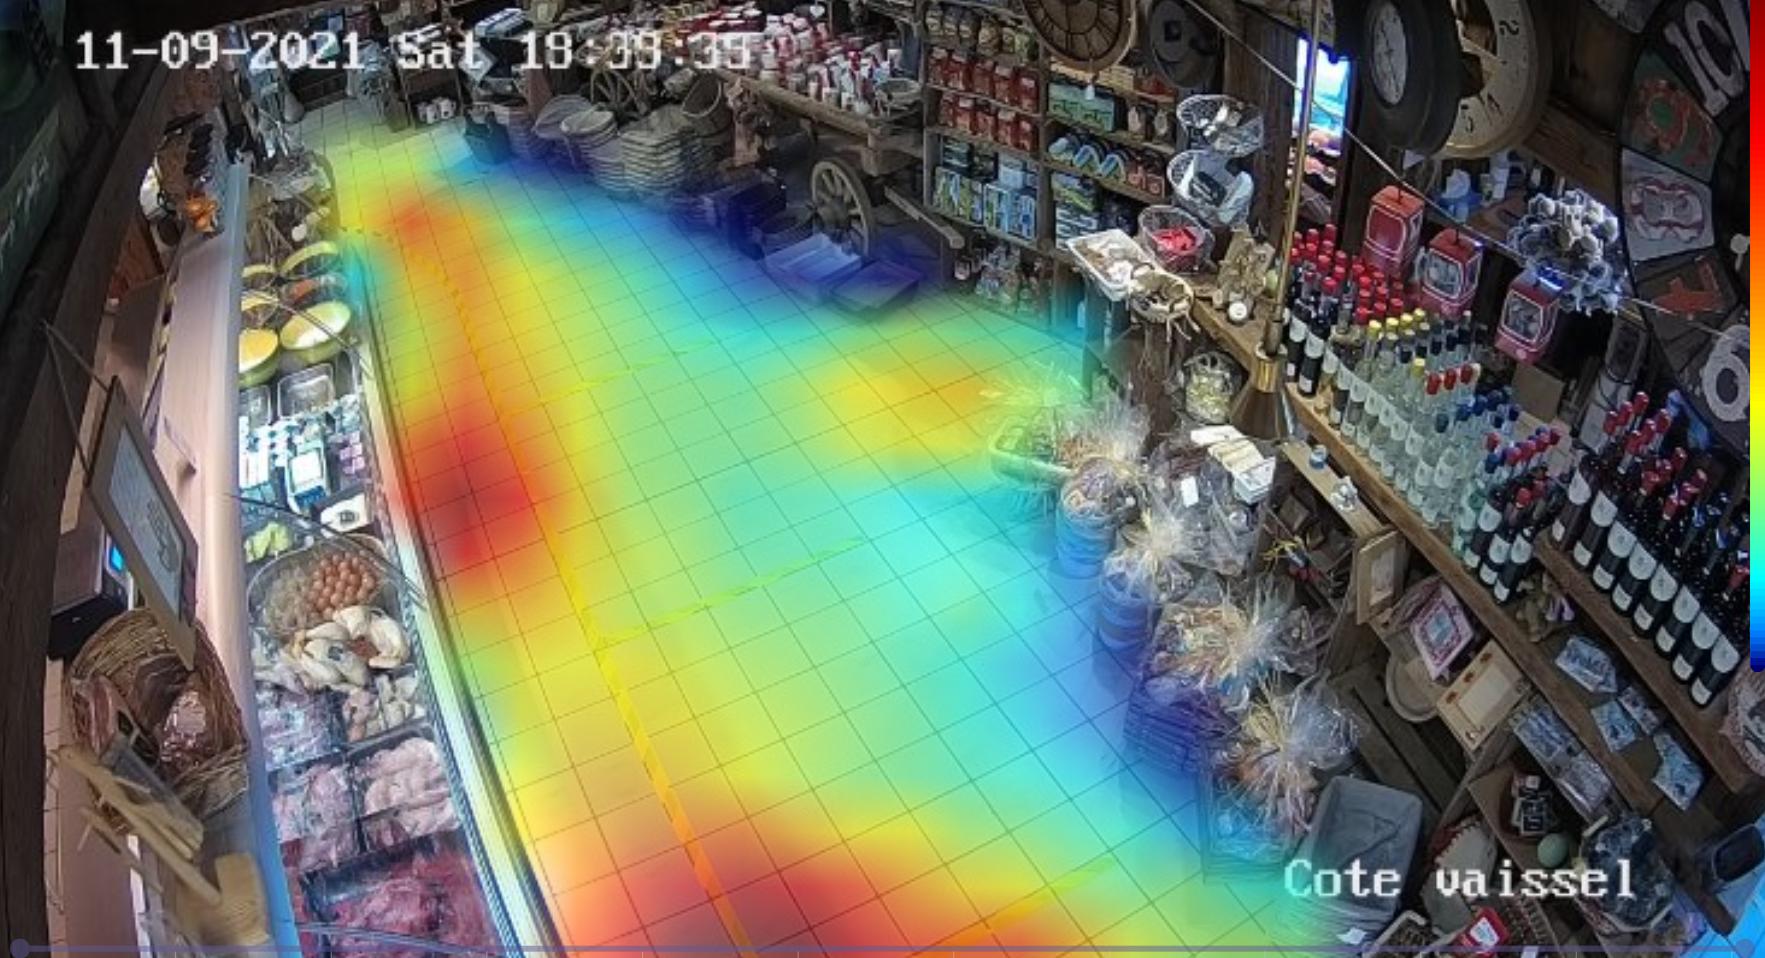
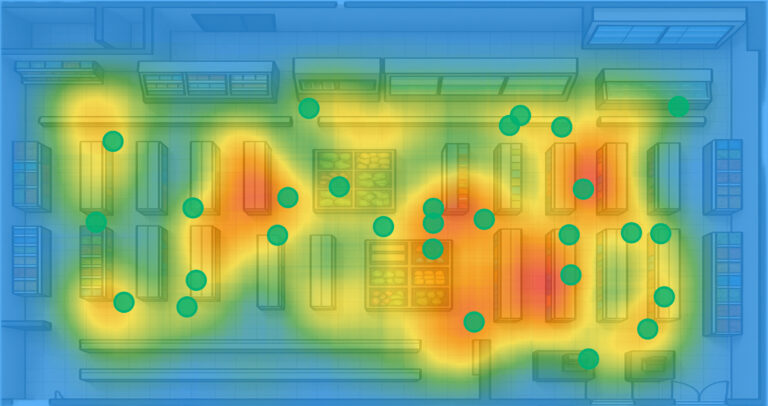
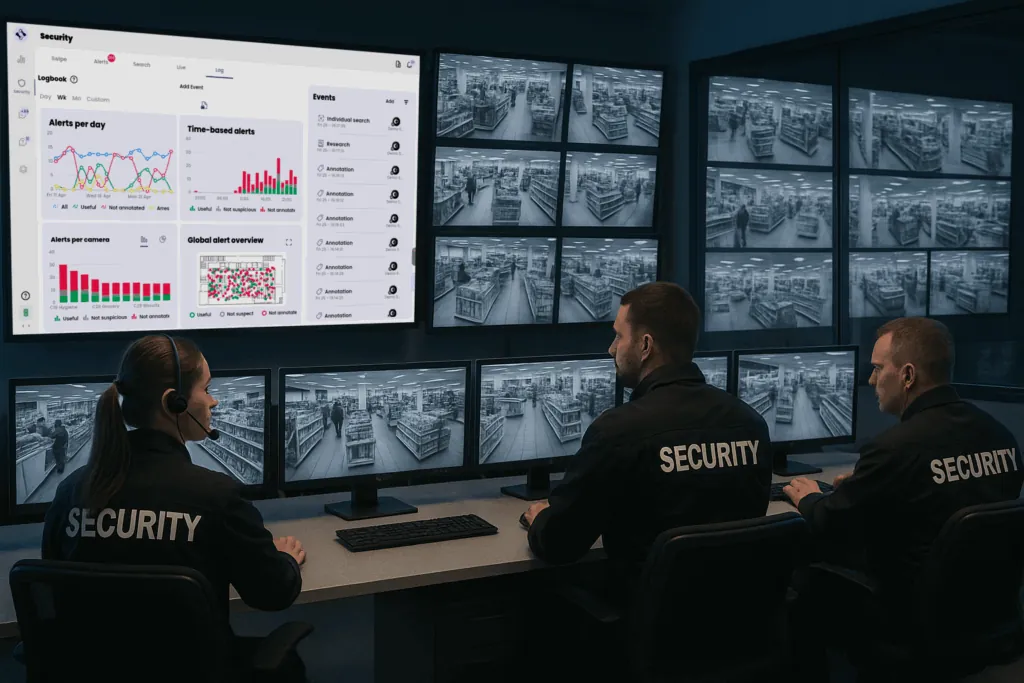
De gegevens van de camera’s nemen hier het stokje over van de inventaris. De dashboards voor videoanalyse, zoals die van Oxania, combineren bezoekerstelling, heatmaps en statistieken per zone en per tijdsblok. Ze vervangen de inventaris niet, die de maatstaf blijft voor het werkelijke verlies, maar ze komen continu binnen in plaats van een of twee keer per jaar. De kaart van risicovolle gebaren per zone biedt dan een basis om vergelijkbare schappen van de ene winkel met die van de andere te vergelijken.
Let wel: het aantal alerts hangt ook af van wat de camera's zien. Een winkel waarvan de uitgestalde schappen goed gedekt zijn, zal meer gebeurtenissen melden dan een winkel vol dode hoeken, zonder daarom meer getroffen te zijn. Om te vergelijken, zet u de alerts af tegen de drukte in de zone en controleert u of de cameradekking van de ene locatie tot de andere gelijkwaardig is. Anders is het de best uitgeruste winkel die er de dupe van wordt.
Een ranglijst vervangen door een vergelijking die helpt bij het beslissen
Een ranglijst van 1 tot N die naar het hele netwerk wordt verspreid, veroorzaakt een bekend perverse effect bij controllers: uiteindelijk wordt de indicator gepoetst in plaats van de realiteit. Breuk wordt ineens met veel ijver gemeld in de week voorafgaand aan de inventarisatie, en sommige boekingen schuiven van de ene periode naar de andere. En de teams van structureel kwetsbaardere winkels, die jaar na jaar onderaan de ranglijst staan, haken af.
Een vergelijking die nuttig is voor het aansturen van meerdere vestigingen ziet er eerder zo uit:
- Vergelijkbare groepen winkels, samengesteld op basis van formaat, locatie en grootte.
- Voor elke winkel drie indicatoren naast elkaar (per omzet, per bezoeker, per oppervlakte) in plaats van slechts één.
- Een trend over minstens drie periodes, om een eenmalig incident te onderscheiden van een structurele afwijking.
- Leesbanden (binnen de groepsnorm, te onderzoeken, duidelijk erboven) in plaats van een ranglijst.
- Een zoom per zone en per tijdslot voor de winkels die buiten hun bandbreedte vallen, voordat er conclusies worden getrokken.
- Een gesprek met de winkelleiding om het verschil toe te lichten: werkzaamheden, ploegwissel, herinrichting van het winkelplan, leveringsproblemen.
Deze aanpak bouwt voort op de kernindicatoren om verliezen te voorspellen. Het doel is niet om een slechte leerling aan te wijzen, maar om te ontdekken wat werkt in de winkels die het best presteren, zodat dit elders kan worden toegepast.
Wanneer eind januari de voorraadcijfers binnenkomen, is het sorteren van een kolom in tien seconden gebeurd. De meting harmoniseren, omzet, bezoekersaantallen en oppervlakte met elkaar kruisen en vervolgens afdalen naar het niveau van de zone en het tijdslot kost meer moeite, maar de vergadering die daarop volgt heeft niet meer hetzelfde doel: we zoeken niet langer uit wie laatste staat, maar vragen ons af waar en wanneer we verliezen, en waarom. Vanuit die vraag daalt de onbekende derving duurzaam binnen het hele netwerk.